
Day 3 曾經介紹過 Linear Representation Hypothesis:某些 concept 可能以 activation space 中相對簡單的 direction 表示。Day 4 的 Linear Probe,則讓我們嘗試把這些 directions 讀出來。但如果一個 direction 真的和某項 concept 有關,除了把它讀出來,我們是不是也能反過來「直接把這個 direction 加進模型,讓模型表現出更多這項性質?」例如,假設 activation space 中存在一個「正面情緒」的 direction。如果我們在模型生成文字時,不斷把 activation 往這個方向推,模型的輸出會不會變得更正面?
這就是 Activation Steering 的基本想法。
最簡單的方法,是先準備一組具有對比關係的輸入。例如:
Positive:I loved this movie.
Negative:I hated this movie.
一句話明顯正向情緒、一句話明顯負向情緒。我們把兩句話分別輸入模型,並從相同的 layer 與 token position 取得 Residual Stream activation:
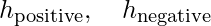
接著直接相減:
這個 difference vector 可以被理解成:
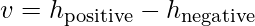
從 negative representation 移動到 positive representation 的方向。接著,在模型處理另一個 prompt 時,把這個 direction 加進它的 activation:
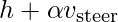
其中 alpha 是 steering strength。
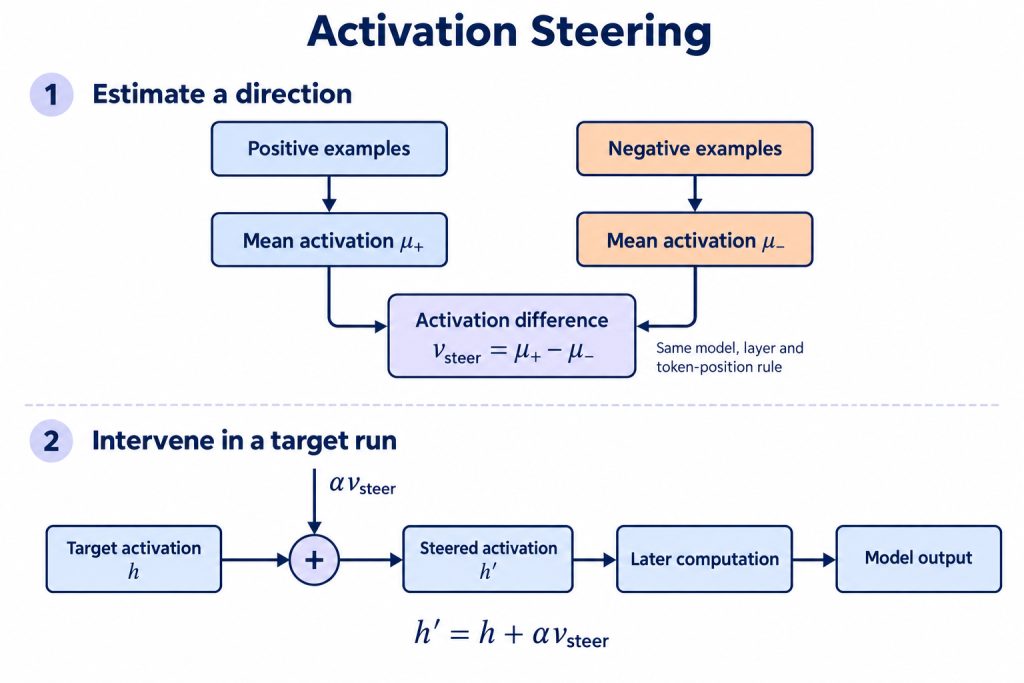
Turner 等人提出的 Activation Addition(ActAdd)就採用這種簡潔的做法:利用一組對比 prompts 的中間 activation difference 建立 steering vector,再於 inference 時把它加回模型。[1] 它不需要重新訓練語言模型,也不需要更新 weights。我們只是在模型 forward pass 的途中,稍微改變它當下的內部狀態。
只使用:
Love − Hate
這樣一組 prompt pair 很直覺,但也可能混入很多我們不想要的差異。例如兩個 prompts 可能不只在情緒上不同,也可能有不同的 token、句型或語境。因此,更穩定的做法是準備多組 contrastive examples:
This is wonderful.  − This is terrible.
I feel very happy.  − I feel very sad.
The experience was pleasant. − The experience was awful.
……
再把每一組 activation difference 平均:
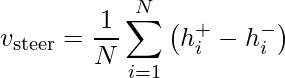
這就是 Contrastive Activation Addition(CAA)的核心做法。[2] 平均多組 examples 的目的,是讓不同句子的偶然差異互相抵銷,留下比較穩定、比較接近目標 behavior 的 direction。(正負例子數量一樣時、每個 pair 權重一樣的情況下先各自平均再減或是先減再平均是一樣的,但或許理解成「先各自平均再減」會比較直觀一點,就是透過增加各自的案例數並平均來找到一個「center of mass」,代表「更乾淨」的正 or 負向的那個概念本身,再將這兩個相減,得到一個從正推到負的方向 or vice versa)
CAA 不只可以處理情緒。只要能設計合理的 positive / negative examples,就可以嘗試建立與下列 behavior 有關的 vectors:
這並不代表每個複雜 behavior 都真的只是一條 direction。但 contrastive activation 提供了一種非常便宜的實驗方式:先找一條候選 direction,再看看介入它會發生什麼。
今天的 companion notebook 會使用 GPT-2 Small,先從多組正面與負面句子中取得 activation:
positive_acts = get_activations(
    positive_texts,
    layer=steering_layer
)

negative_acts = get_activations(
    negative_texts,
    layer=steering_layer
)
接著建立 mean-difference steering vector:
steering_vector = (
    positive_acts.mean(dim=0)
    - negative_acts.mean(dim=0)
)

steering_vector = steering_vector / steering_vector.norm()
最後,在模型處理 target prompt 時,把 direction 加進 Residual Stream:
def add_steering(resid, hook):
    return resid + alpha * steering_vector

steered_logits = model.run_with_hooks(
    target_tokens,
    fwd_hooks=[(hook_name, add_steering)]
)
完整實作需要處理:
正文先不塞入這些工程細節。真正的核心只有兩步:
從 contrastive examples 算出 direction
↓
把 direction 加進新的 activation
假設我們逐漸提高 alpha,一開始,target behavior 可能逐漸增強。但當 steering 太強時,模型可能開始重複某些字詞、降低語言流暢度、忽略原本 prompt、影響其他不相關能力。
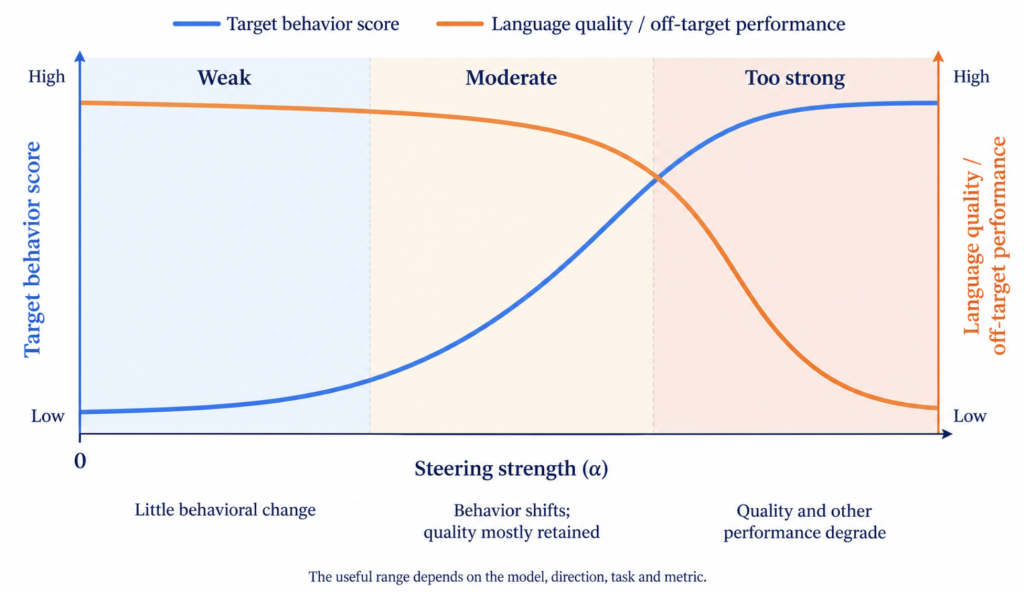
因此,steering 的評估不能只問「目標 behavior 有沒有變?」還要同時問:
否則我們可能只是把模型的 activation 推離正常分布,再把產生的異常輸出誤認為精準控制。
Activation Steering 最引人注意的案例之一,是模型的 refusal behavior。Arditi 等人分析了 13 個開源 chat models,發現 refusal behavior 可以由一個一維 subspace 強烈介導:加入這個 direction,模型甚至可能拒絕原本無害的要求;移除它,則可能顯著削弱模型對有害要求的拒絕能力。[3]
這個結果同時展示了 activation steering 的力量與風險。一方面,它表示某些看似複雜的 safety behavior,可能存在非常低維、可被介入的內部結構。另一方面,它也暴露了 safety fine-tuning 的脆弱性:
如果一個重要的安全行為過度依賴少數簡單 directions,那麼理解這些 directions 的人,也可能利用它們繞過安全機制。
Interpretability 並不只會讓模型更安全。同一套理解,也可能被用來削弱模型的安全性。因此,知道怎麼 steer 模型,只是問題的一半;另一半是如何 audit、限制並防禦這類內部介入。
假設我們加入某個 direction 後,模型的回答真的變得更正面。這提供了一條很有價值的 intervention evidence。但它仍然不一定證明「模型平常就是靠這一條 direction 形成所有正面情緒。」
原因包括:
這正是 Day 5 講過的區別,能控制一個系統,不等於已經完整理解它平常如何工作。Activation Steering 可以是一個很好的 causal experiment,也可以是一個實用的 model-control tool;但它不會自動替我們完成 mechanistic explanation。
不過這些 caveat 都是在「解釋」、「理解」時需要注意的,在之前我們也已經重複過許多次。如果我們從「實用」、「控制」的角度出發,能夠可靠、精準的 Steering 就已經是非常有幫助的發現了。這也是在 Mechanistic Interpretability 中,Actionability 在意的「how effectively an interpretation of a model can be used to control, edit, or improve that model」
今天的 steering vector 比較像在控制一種 high-level property,例如 sentiment、topic 或 refusal tendency。但模型裡會不會還存在另一類 vectors:
不是表示「模型現在偏向什麼」,而是直接觸發一項可以重複使用的功能?
例如:
下一篇,我們會介紹 Function Vectors、Task Vectors,以及更廣義的 Representation Engineering。
[1] Turner, A. M., Thiergart, L., Leech, G., et al., “Steering Language Models With Activation Engineering”, 2023. https://arxiv.org/abs/2308.10248
[2] Rimsky, N., Gabrieli, N., Schulz, J., Tong, M., Hubinger, E., & Turner, A., “Steering Llama 2 via Contrastive Activation Addition”, Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics (ACL), 2024. https://aclanthology.org/2024.acl-long.828/
[3] Arditi, A., Obeso, O., Syed, A., et al., “Refusal in Language Models Is Mediated by a Single Direction”, Advances in Neural Information Processing Systems (NeurIPS), 2024. https://proceedings.neurips.cc/paper_files/paper/2024/hash/f545448535dfde4f9786555403ab7c49-Abstract-Conference.html


 iThome鐵人賽
 看影片追技術